Kí tự đặc biệt là gì? Giải mã Unicode đằng sau ký tự
Kí tự đặc biệt là những ký tự nằm ngoài bộ chữ và số thông thường của bàn phím — ký hiệu hình học, mũi tên, khung trang trí, chữ kiểu, emoji — và tất cả đều là ký tự…
Kí tự đặc biệt là những ký tự nằm ngoài bộ chữ và số thông thường của bàn phím — ký hiệu hình học, mũi tên, khung trang trí, chữ kiểu, emoji — và tất cả đều là ký tự Unicode chứ không phải hình ảnh hay font cài thêm. Bài này giải thích thứ nằm dưới lớp hiển thị: một ký tự thực ra được máy lưu bằng gì, đi qua những lớp nào trước khi thành hình bạn nhìn thấy, và vì sao cùng một ký tự lại ra kết quả khác nhau trên hai thiết bị.
Kí tự đặc biệt là gì
Về mặt kỹ thuật, không có nhóm nào tên là “ký tự đặc biệt” trong chuẩn Unicode. Đó là cách gọi dân dã cho mọi ký tự người dùng không gõ thẳng được từ bàn phím: ★ ✿ ꧁ ➶ 彡 𝓐 🙂. Với máy tính thì chúng bình đẳng hoàn toàn với chữ A hay số 7 — cùng là ký tự, cùng có một số hiệu, cùng được truyền đi như nhau.
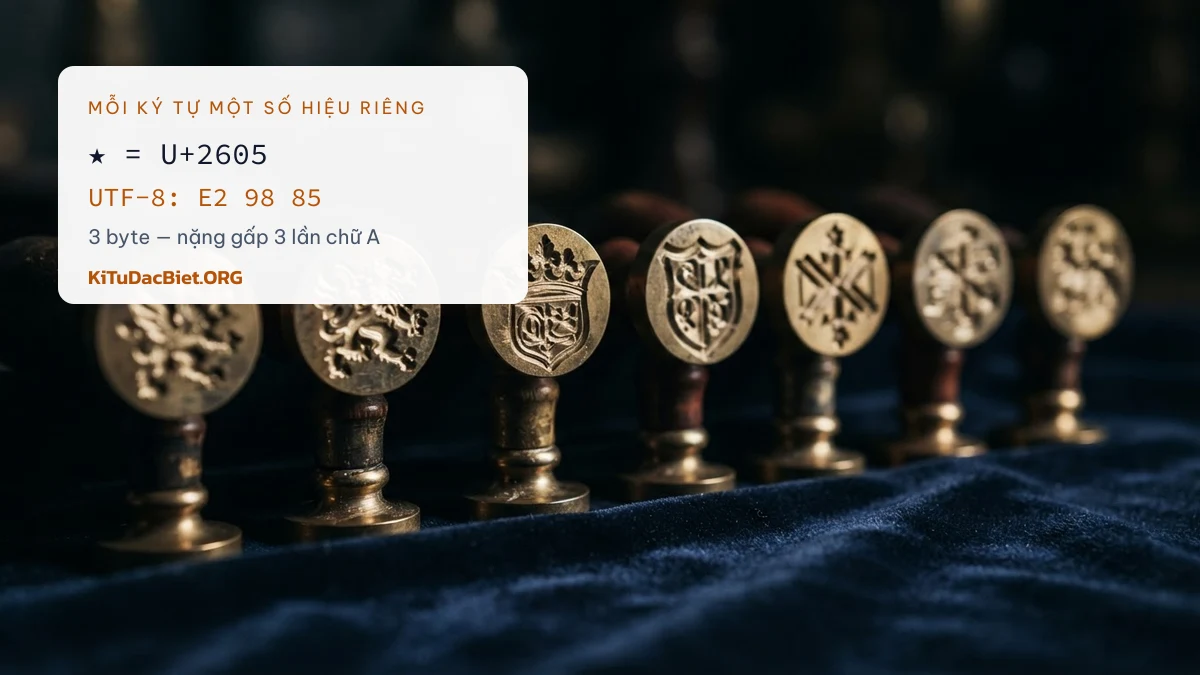
Unicode là một bảng danh mục do Unicode Consortium duy trì, gán cho mỗi ký tự của mọi hệ chữ viết trên thế giới một con số duy nhất. Con số đó gọi là code point, viết theo dạng U+ kèm số hệ mười sáu. Chữ A là U+0041, ngôi sao ★ là U+2605. Toàn bộ kho ký tự trên KiTuDacBiet.ORG — kí tự đặc biệt chỉ là những con số như vậy được sắp lại cho dễ tìm.
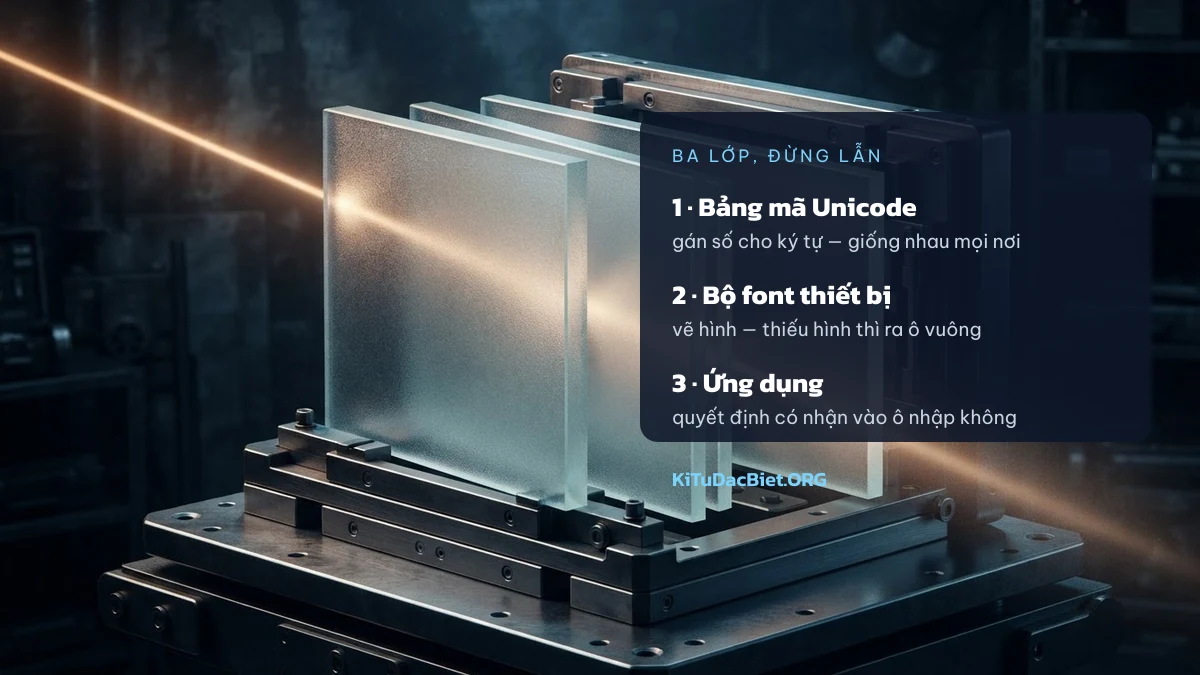
1. Bảng mã — Unicode gán số cho ký tự. Số này giống nhau ở mọi nơi trên thế giới.
2. Bộ font — phần mềm vẽ hình cho từng số. Mỗi thiết bị có bộ font riêng, và không bộ nào phủ hết. Thiếu hình thì vẽ ô vuông.
3. Ứng dụng — quyết định có nhận ký tự đó vào ô nhập hay không. Đây là lớp lọc, không liên quan gì tới hai lớp trên.
Giải phẫu một ký tự: từ số hiệu tới byte (bảng tra 09/2026)
Giữa “code point” và “cái máy thật sự lưu” còn một bước nữa: cách mã hoá. UTF-8 là cách phổ biến nhất trên web, nó biến một code point thành từ một đến bốn byte. UTF-16 là cách nhiều ngôn ngữ lập trình dùng trong bộ nhớ, và là lý do một số ô nhập đếm ký tự lạ. Bảng dưới lấy bảy ký tự đại diện rồi in ra đúng những byte máy lưu:
| Ký tự | Code point | Khối Unicode | Byte UTF-8 | Số byte | UTF-16 |
|---|---|---|---|---|---|
| A | U+0041 |
Latin Basic | 41 |
1 | 0041 |
| đ | U+0111 |
Latin Extended-A | C4 91 |
2 | 0111 |
| ★ | U+2605 |
Miscellaneous Symbols | E2 98 85 |
3 | 2605 |
| ꧁ | U+A9C1 |
Javanese | EA A7 81 |
3 | A9C1 |
| 彡 | U+5F61 |
CJK Unified Ideographs | E5 BD A1 |
3 | 5F61 |
| 𝓐 | U+1D4D0 |
Mathematical Alphanumeric Symbols | F0 9D 93 90 |
4 | D835 DCD0 |
| 🙂 | U+1F642 |
Emoticons | F0 9F 99 82 |
4 | D83D DE42 |
Bảng này giải thích ba chuyện thường bị hiểu nhầm:
- Ký tự càng “lạ” càng nặng. Chữ A tốn 1 byte, chữ đ tốn 2, ngôi sao ★ tốn 3, còn chữ kiểu 𝓐 và emoji 🙂 tốn tới 4 byte. Một cái tên toàn ký tự trang trí nặng gấp bốn lần cùng số ký tự viết bằng chữ Latin.
- Vì sao có ô nhập đếm emoji thành 2. Ở cột UTF-16, 𝓐 và 🙂 không phải một đơn vị mà là một cặp (D835 DCD0 và D83D DE42). Ô nhập nào đếm theo đơn vị UTF-16 sẽ tính chúng là hai ký tự — đúng như bảng đo trong bài kí tự đặc biệt Play Together: Sân chơi social.
- Khối Unicode cho biết mức rủi ro. Ký tự nằm ở khối càng phổ thông thì càng nhiều bộ font phủ. ★ thuộc Miscellaneous Symbols, gần như máy nào cũng có; ꧁ thuộc khối Javanese, hẹp hơn nhiều, nên hay ra ô vuông.
Vì sao ký tự hiện thành ô vuông
Ô vuông — dân gian gọi là “tofu” vì trông như miếng đậu phụ — không phải lỗi chép sai và không phải ký tự hỏng. Byte vẫn nguyên vẹn, số hiệu vẫn đúng. Chỉ là bộ font đang dùng không có hình cho code point đó, nên phần mềm vẽ một khung rỗng để báo “tôi biết đây là một ký tự nhưng không biết vẽ thế nào”.
Hệ quả thực tế: hình bạn thấy do thiết bị của người xem quyết định, không phải máy người gửi. Cùng một cái tên có thể đẹp trên điện thoại của bạn và vỡ trên máy bạn bè, mà không ai làm gì sai. Cách giảm rủi ro duy nhất là chọn ký tự ở các khối phổ thông.
Kho ví dụ xếp theo khối Unicode
Bốn lưới dưới xếp theo khối thật trong bảng mã, không theo chủ đề trang trí. Xếp kiểu này giúp bạn thấy ngay ký tự nào ở gần nhau trong bảng mã — và ký tự cùng khối thường cùng số phận về font.
Chữ kiểu, kaomoji, emoji — cùng một cơ chế
Ba thứ trông rất khác nhau này đều chỉ là ký tự Unicode: chữ kiểu là ký tự trong khối toán học, kaomoji là nhiều ký tự thường ghép lại, emoji là ký tự ở khối emoji. Không thứ nào cần cài font, và cả ba đều chịu chung ba lớp đã nói ở trên.
Muốn tra sâu hơn một nhóm cụ thể: khối chữ kiểu có bảng riêng ở bài kí tự chữ đặc biệt, còn nhóm ký tự không vẽ ra hình nào nằm ở bài kí tự khoảng trống. Tài liệu gốc của bảng mã do Unicode Consortium công bố.
Câu hỏi thường gặp
Kí tự đặc biệt có phải font không?
Không. Font là bộ hình vẽ, còn ký tự là số hiệu. Khi bạn chép ★ đi nơi khác, thứ được chuyển là số U+2605 chứ không phải hình ngôi sao; nơi nhận tự lấy hình từ font của nó. Đó là lý do bạn không cần cài gì để dùng, và cũng là lý do hình có thể khác nhau giữa hai máy.
Vì sao chép ký tự vào ô đăng nhập lại bị từ chối?
Vì đó là lớp thứ ba — lớp ứng dụng. Ô đăng nhập cố ý chỉ nhận một tập ký tự hẹp để tránh nhầm lẫn và tránh lỗi bảo mật. Ký tự vẫn hoàn toàn hợp lệ, chỉ là ô đó không nhận.
Có bao nhiêu ký tự đặc biệt tất cả?
Unicode hiện gán số cho hơn một trăm bốn mươi nghìn ký tự, trải trên hàng trăm khối. Nhưng phần thực sự dùng được để trang trí thì nhỏ hơn nhiều, vì phải chọn những ký tự mà đa số thiết bị có font phủ — đó chính là công việc chọn lọc của trang này.
Ký tự đặc biệt có ảnh hưởng tới bảo mật tài khoản không?
Bản thân ký tự thì không. Nhưng cần biết một điều: có những cặp ký tự khác số hiệu mà trông giống hệt nhau, nên tên hiển thị không phải thứ đáng tin để nhận diện một người. Hãy dựa vào tên đăng nhập hoặc đường dẫn trang, đó mới là phần bị ràng buộc chặt.